AI가 쓴 한국어 글은 읽다
AI가 쓴 한국어 글은 읽다 보면 어딘가 티가 납니다. 유독 콤마와 대시가 많죠. 왜 그럴까요.
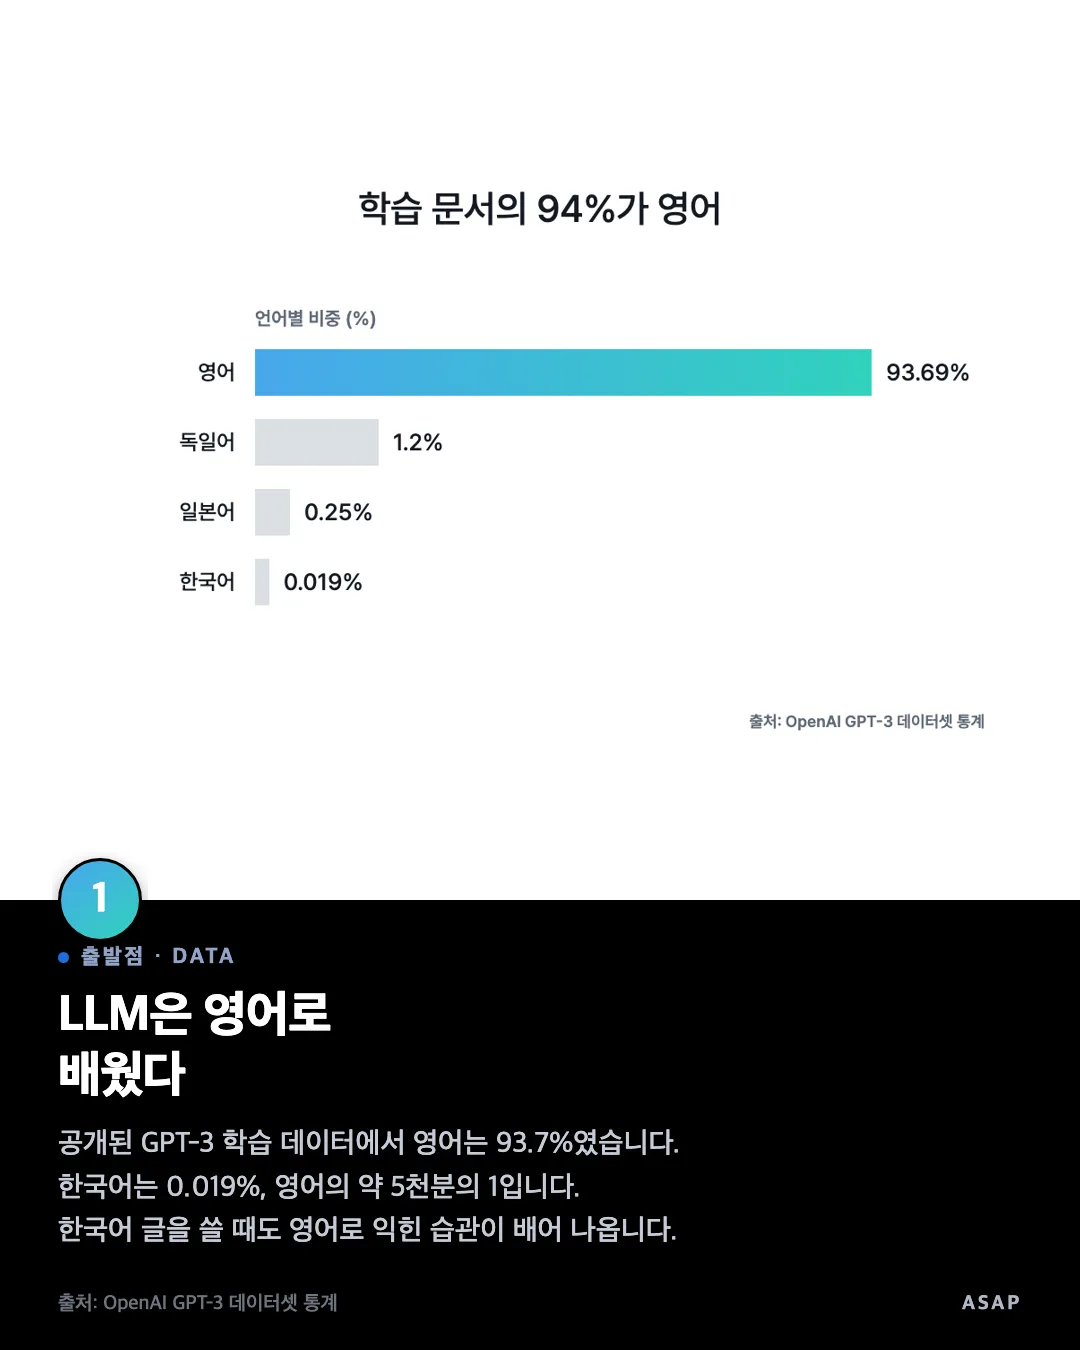
출발점은 학습 데이터입니다. 공개된 GPT-3 학습 데이터에서 영어 문서는 93.7%였습니다. 한국어는 0.019%로 영어의 약 5천분의 1이었습니다. 최근 모델들은 구성을 공개하지 않지만 영어가 압도적이라는 사실은 달라지지 않았습니다. 결국 모델은 영어로 글쓰기를 배운 셈입니다.
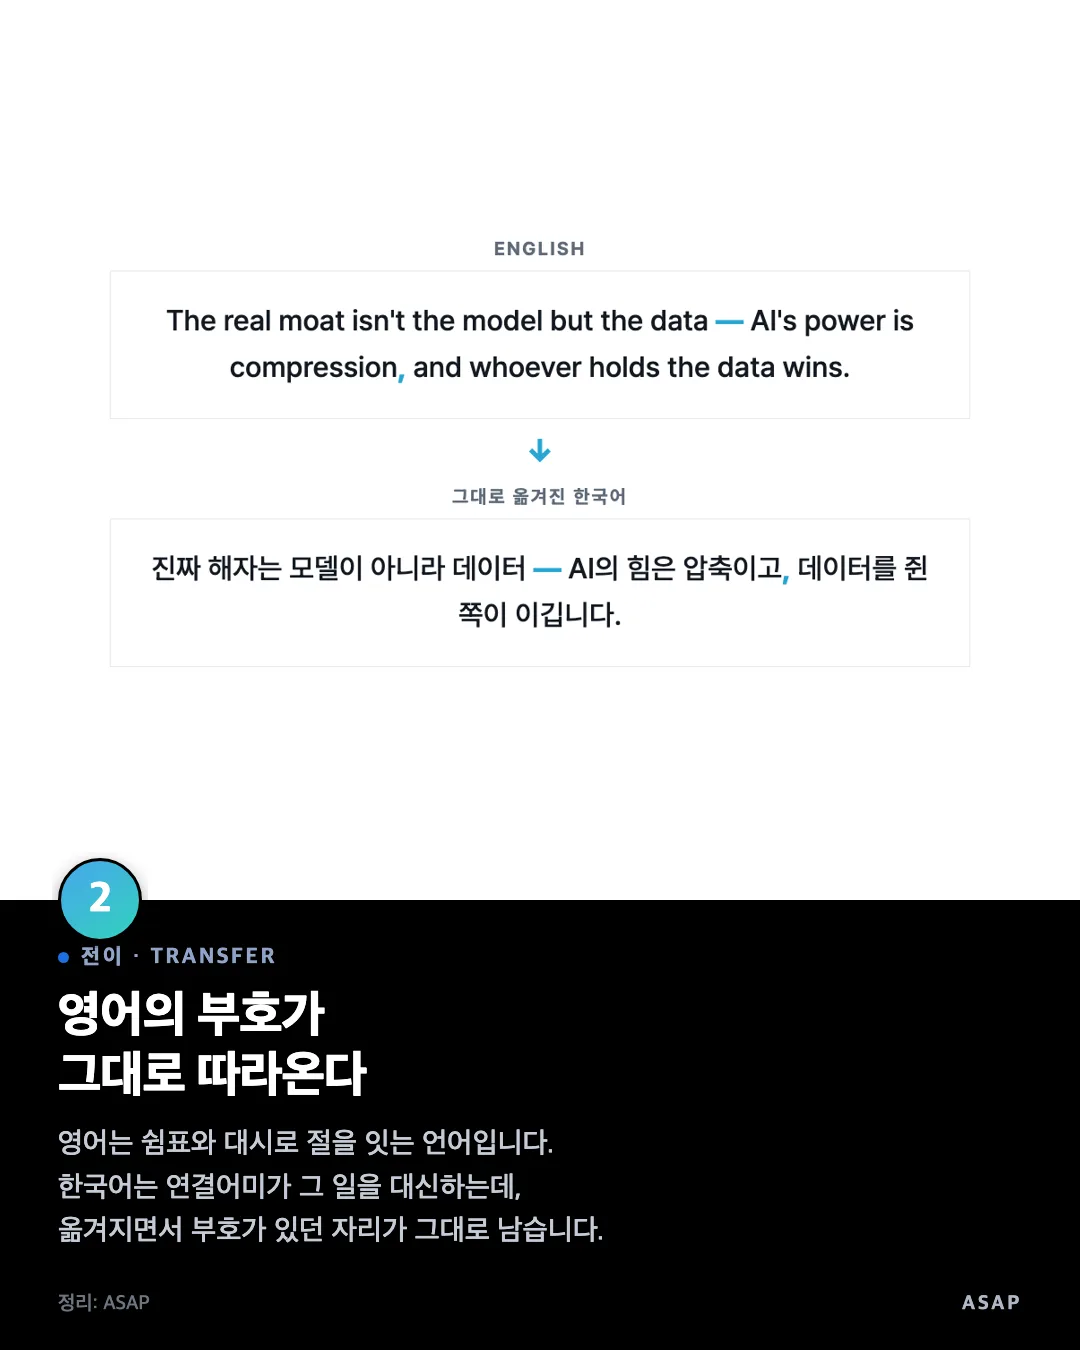
그래서 영어의 부호가 그대로 따라옵니다. 영어는 쉼표와 대시로 절을 잇는 언어입니다. 삽입구도 부연도 전부 그 자리에 들어갑니다. 반면 한국어는 어미와 조사가 그 일을 대신하죠. 그런데 옮겨지는 과정에서 부호가 있던 자리는 그대로 남습니다. 영어 문장과 그 한국어 문장을 나란히 놓고 보면 대시와 쉼표가 똑같은 위치에 서 있는 게 보입니다.
여기에 하나가 더해집니다. 마침표는 문장을 끝내겠다는 결정이라 되돌릴 수 없지만 쉼표와 대시는 뒤에 무엇이 오든 받아줍니다. 문장을 계속 열어두는 쪽이 안전하니 자꾸 이어 붙이게 됩니다.
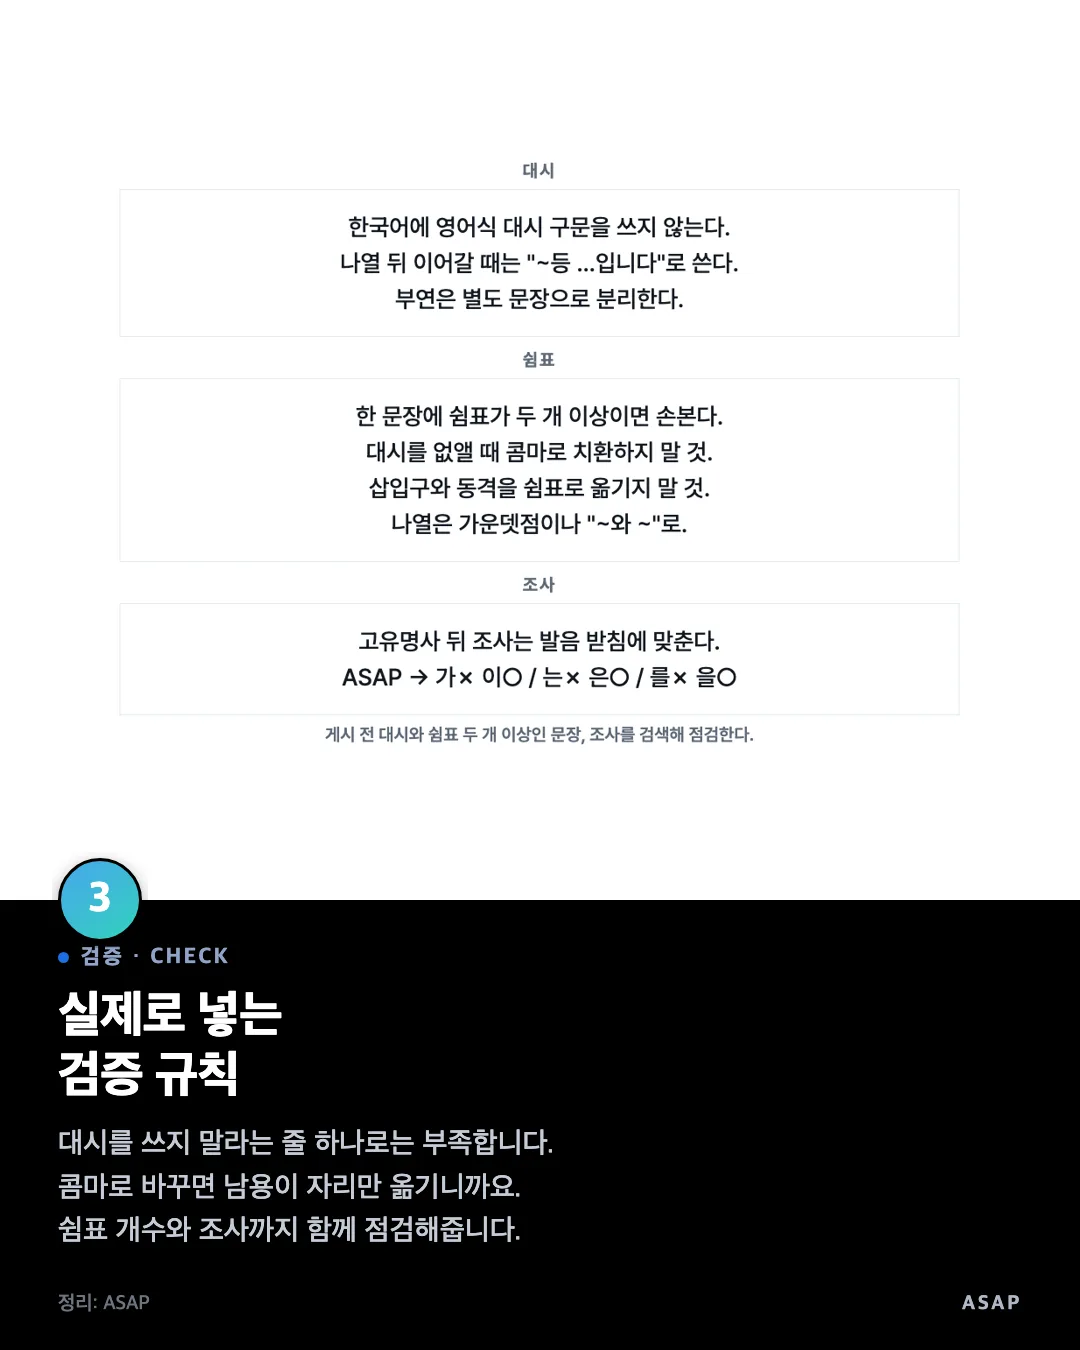
고치려면 검증 규칙을 세 군데에 걸어두면 됩니다. 첫째는 대시입니다. 한국어에 영어식 대시 구문을 쓰지 않고 나열 뒤에 이어갈 때는 "~등 …입니다"로 씁니다. 부연은 아예 별도 문장으로 끊습니다.
둘째는 쉼표입니다. 대시만 막으면 남용이 콤마로 자리를 옮길 뿐이라 여기가 진짜 관문입니다. 한 문장에 쉼표가 두 개 이상이면 손보고 대시를 없앨 때 콤마로 치환하지 않습니다. 삽입구와 동격도 쉼표로 옮기지 않고 나열은 가운뎃점이나 "~와 ~"로 씁니다.
셋째는 조사입니다. 고유명사 뒤 조사는 발음 받침에 맞춥니다. ASAP은 받침으로 끝나니 "ASAP이" "ASAP은" "ASAP을"이 맞습니다.
글을 다 쓰고 대시와 쉼표를 한 번 찾아보는 습관만 들여도 절반은 잡힙니다.
출처 OpenAI GPT-3 데이터셋 통계