앤트로픽 Opus 5.5 공개
성능은 Fable 5.1 수준, 값은 40% 내렸습니다
Claude Opus 5.5가 나왔습니다. 대부분의 일에서 Fable 5.1 수준으로 하면서 Opus 5보다 40% 싸게 돈다고 밝혔습니다.
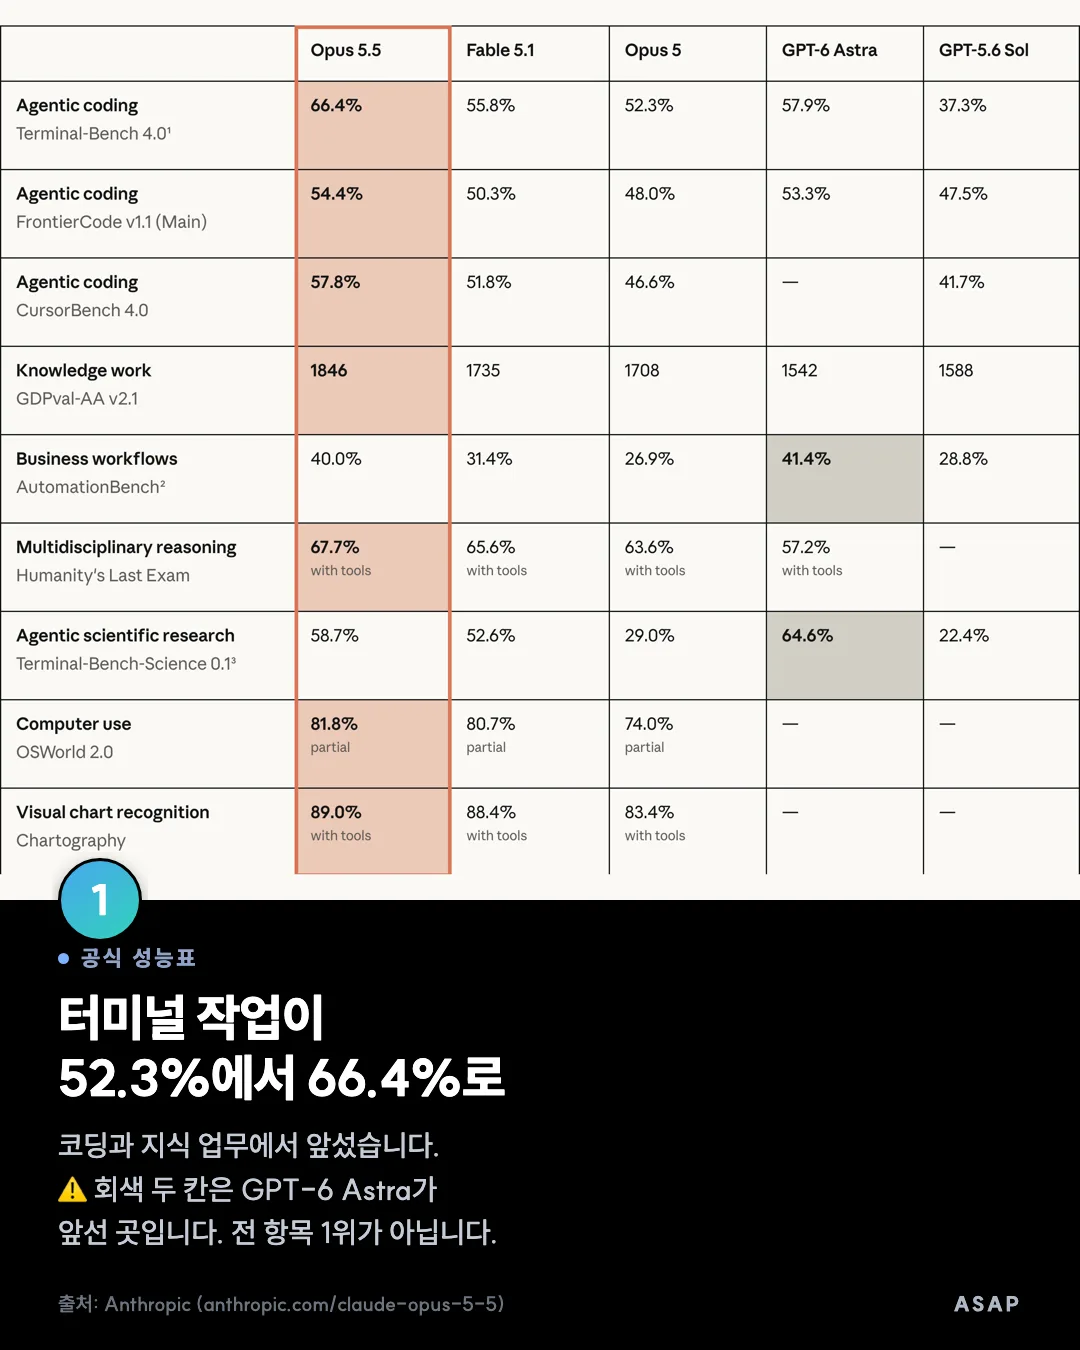
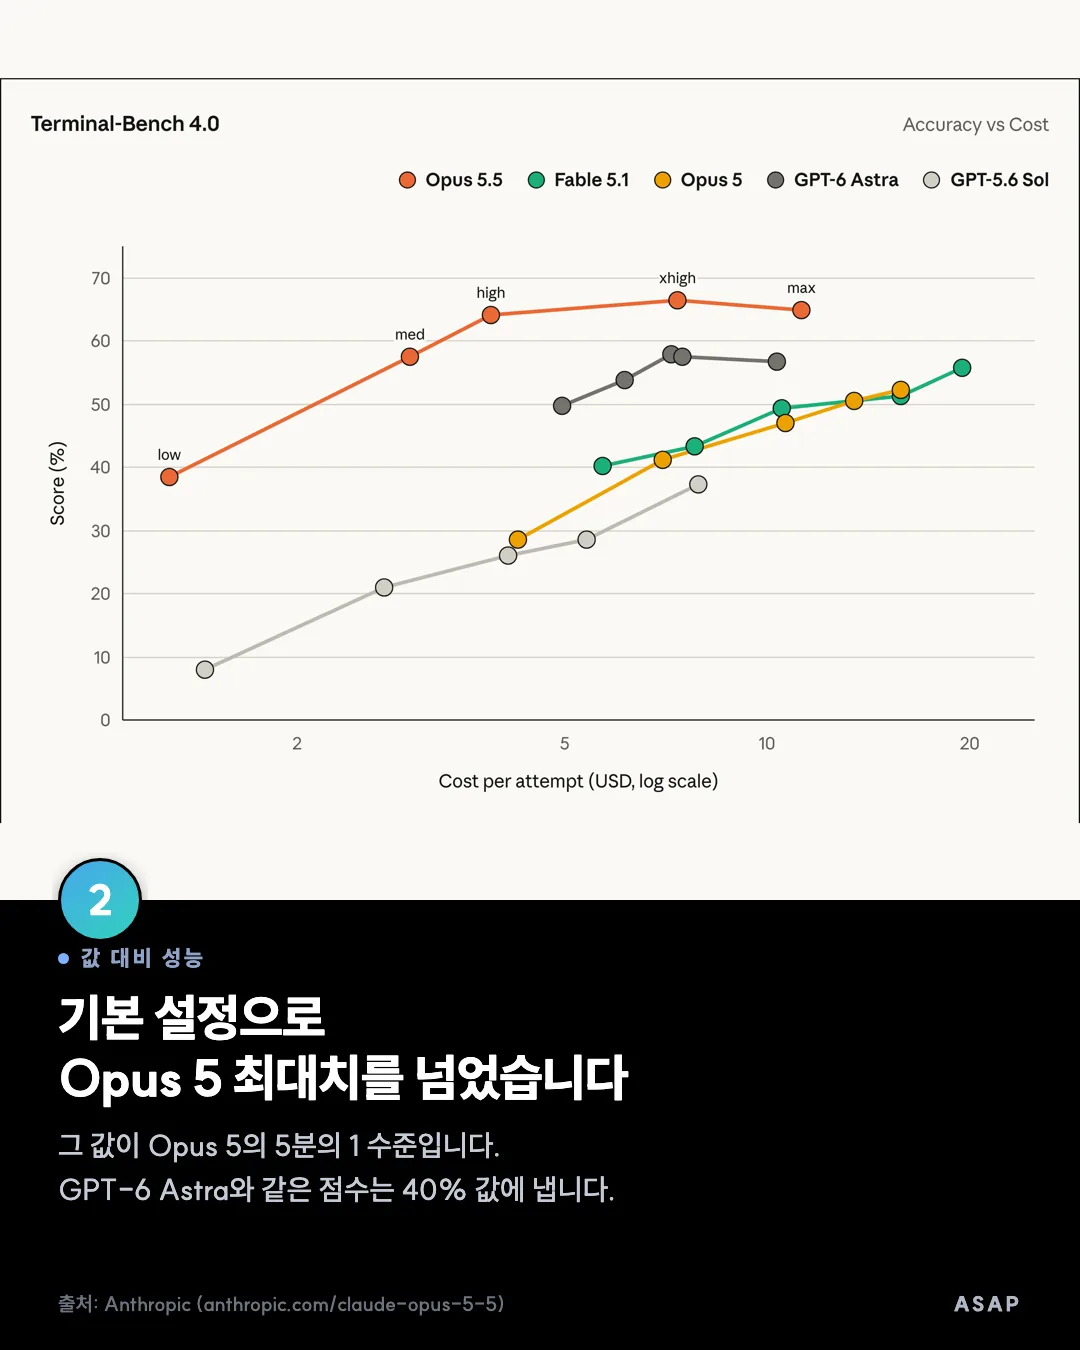
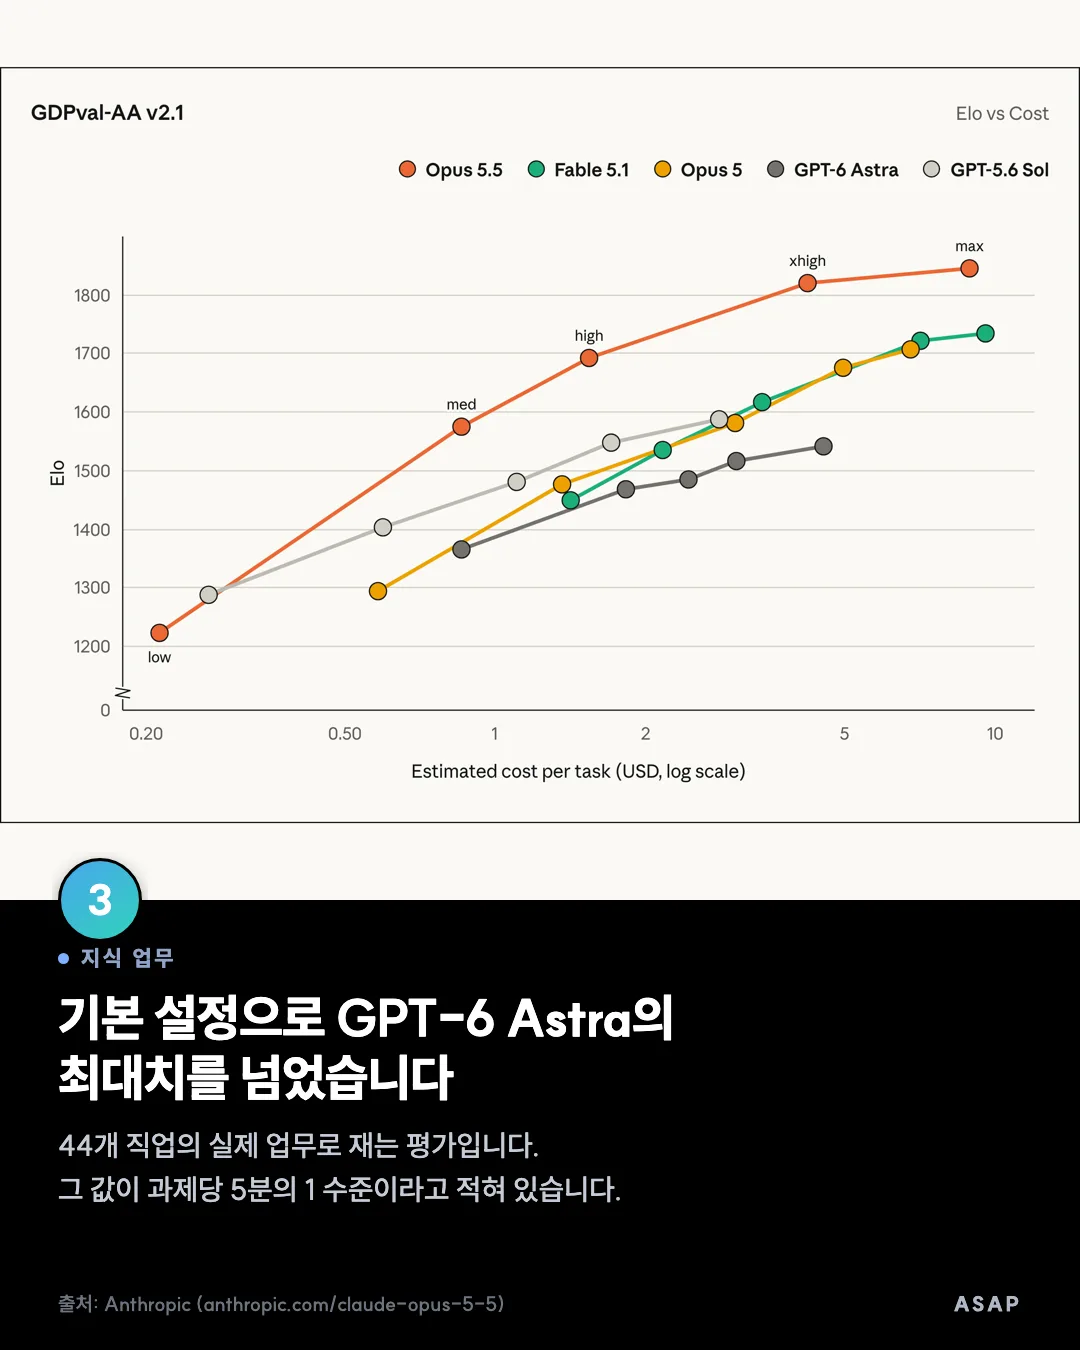
터미널 작업은 52.3%에서 66.4%로 올랐습니다. 지식 업무 지표도 1708에서 1846이 됐습니다. 다만 표 전체에서 1위는 아닙니다. 업무 자동화와 과학 연구 두 항목은 GPT-6 Astra가 앞서고, 앤트로픽은 그 칸을 회색으로 칠해 뒀습니다.
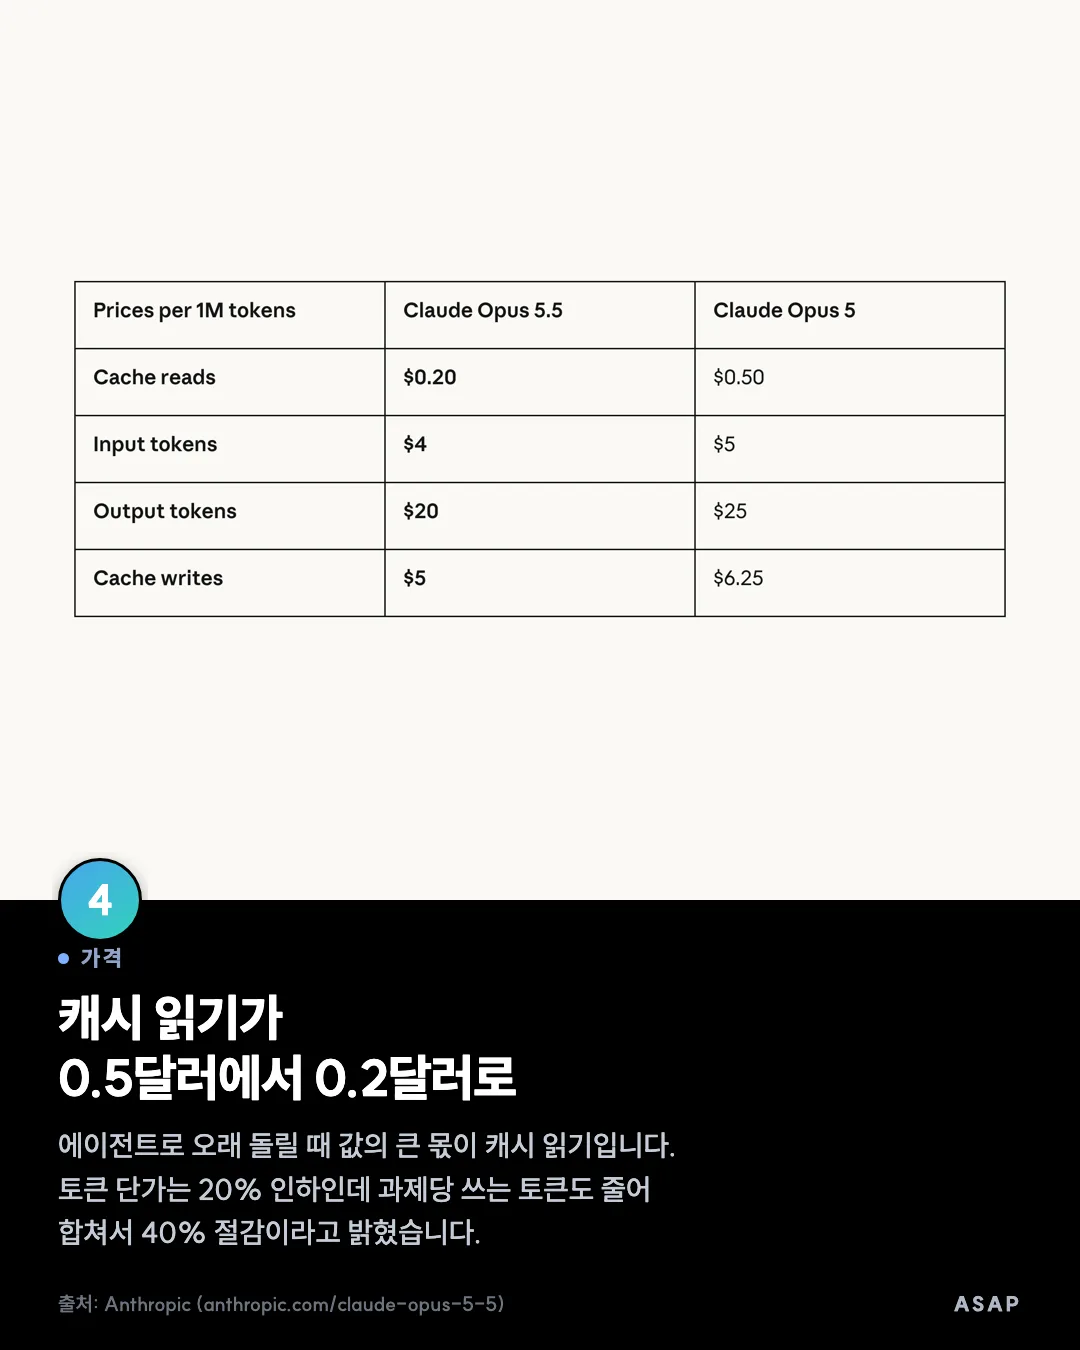
눈에 띄는 건 값입니다. 캐시 읽기가 100만 토큰당 0.5달러에서 0.2달러로 60% 내렸습니다. 에이전트로 오래 돌릴 때 비용의 큰 몫이 여기입니다.
- 입력은 5달러에서 4달러, 출력은 25달러에서 20달러입니다. 토큰 단가는 20% 인하인데 과제당 쓰는 토큰도 줄어 합쳐서 40% 절감이라고 합니다. 출력 속도는 30% 이상 빨라졌습니다.
- 표를 내놓으면서 바로 아래 이렇게 적었습니다. 이 정도 수준에서는 점수 차가 실제 차이를 가늠하는 잣대로 덜 미덥고, 직접 써 보면 Fable 5.1과의 차이가 점수보다 좁다고요.
- 각주도 눈여겨볼 만합니다. 벤치마크를 안전장치를 켠 채로 쟀고, 장치가 개입한 사이버 과제는 Opus 4.8이, 생물학 과제는 Opus 5가 대신 처리했다고 합니다. 그래서 점수가 실제보다 낮게 나왔을 거라고 적었습니다.
- 초기 테스터 사례로 68만 줄 코드 마이그레이션을 하루 안에 끝낸 건이 소개됐습니다. 웹앱 로딩 단축은 40번 중 39번 성공했다고 합니다.
- 정렬 쪽은 지금까지 잰 모델 중 가장 좋은 점수라고 밝혔습니다. 프론티어 감속을 외친 뒤 나온 첫 모델이고, Frontier Design과 METR이 출시 전에 시험했습니다.
- Pro·Max·Team과 좌석형 Enterprise의 5시간 한도가 올라갔습니다. Sonnet 5.5와 Haiku 5.5도 몇 주 안에 나옵니다.
출처 Anthropic (anthropic.com/claude-opus-5-5)
광고
카드 내용
- 공식 성능표터미널 작업이 52.3%에서 66.4%로
코딩과 지식 업무에서 앞섰습니다. ⚠️ 회색 두 칸은 GPT-6 Astra가 앞선 곳입니다. 전 항목 1위가 아닙니다.
출처: Anthropic (anthropic.com/claude-opus-5-5) - 값 대비 성능기본 설정으로 Opus 5 최대치를 넘었습니다
그 값이 Opus 5의 5분의 1 수준입니다. GPT-6 Astra와 같은 점수는 40% 값에 냅니다.
출처: Anthropic (anthropic.com/claude-opus-5-5) - 지식 업무기본 설정으로 GPT-6 Astra의 최대치를 넘었습니다
44개 직업의 실제 업무로 재는 평가입니다. 그 값이 과제당 5분의 1 수준이라고 적혀 있습니다.
출처: Anthropic (anthropic.com/claude-opus-5-5) - 가격캐시 읽기가 0.5달러에서 0.2달러로
에이전트로 오래 돌릴 때 값의 큰 몫이 캐시 읽기입니다. 토큰 단가는 20% 인하인데 과제당 쓰는 토큰도 줄어 합쳐서 40% 절감이라고 밝혔습니다.
출처: Anthropic (anthropic.com/claude-opus-5-5)
광고