작은 모델이 같은 회사의 큰 모델을 이겼습니다.
작은 모델이 같은 회사의 큰 모델을 이겼습니다. 딥시크가 어제 올린 V4-Flash 정식판입니다.
7월 31일 허깅페이스에 올라왔습니다. 4월에 나온 프리뷰를 대체하는 정식 버전이고 에이전트 능력을 크게 손봤다는 것이 회사 설명입니다.
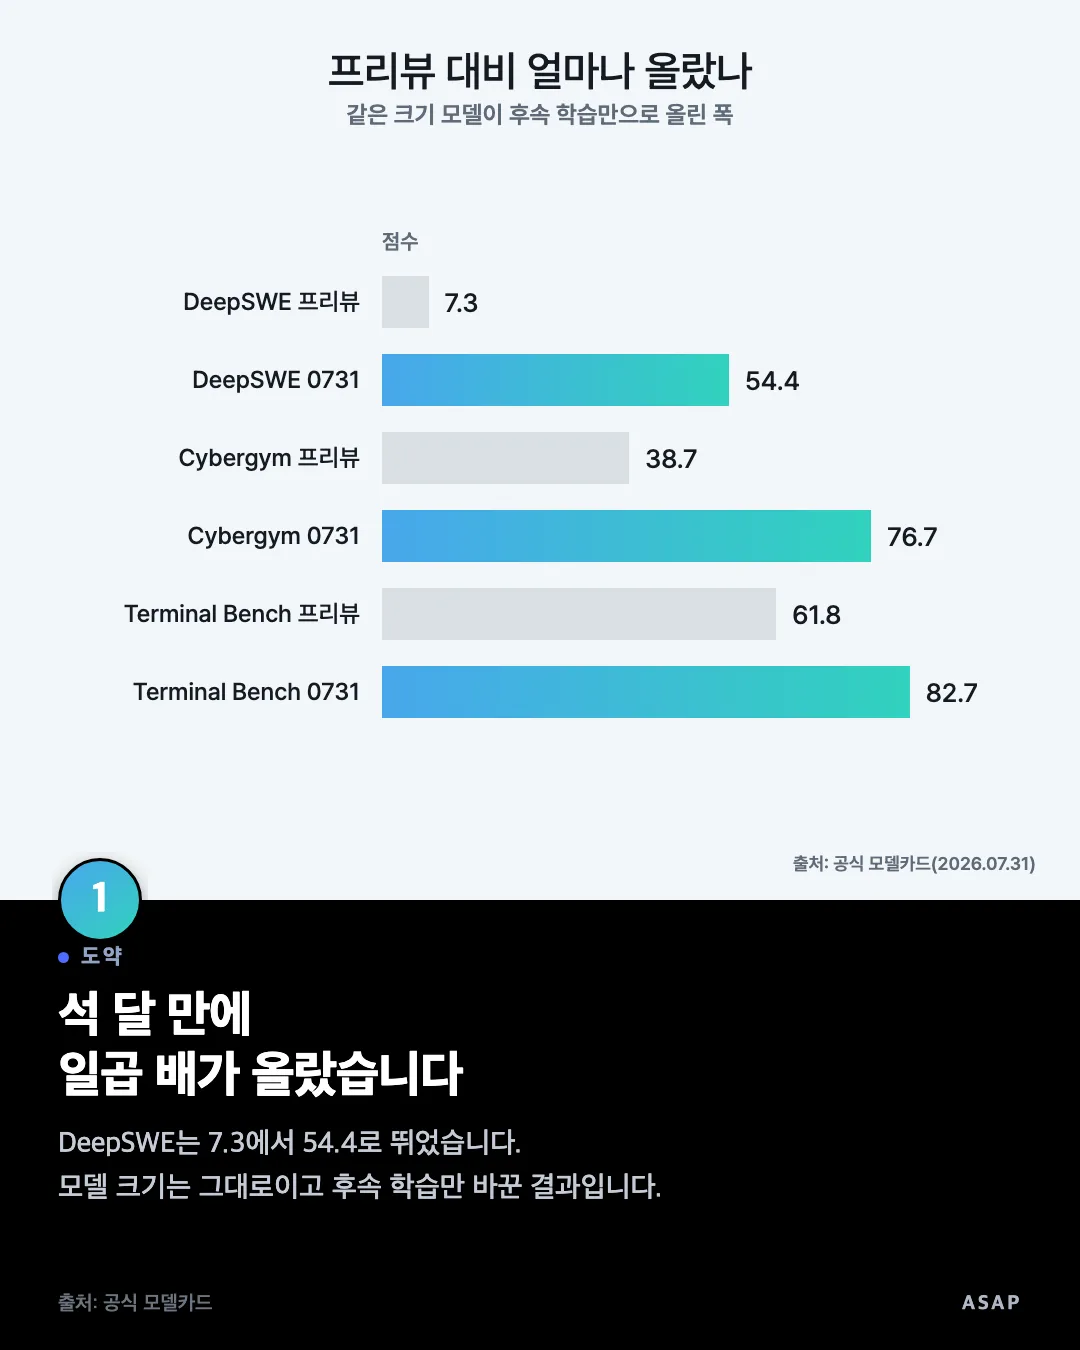
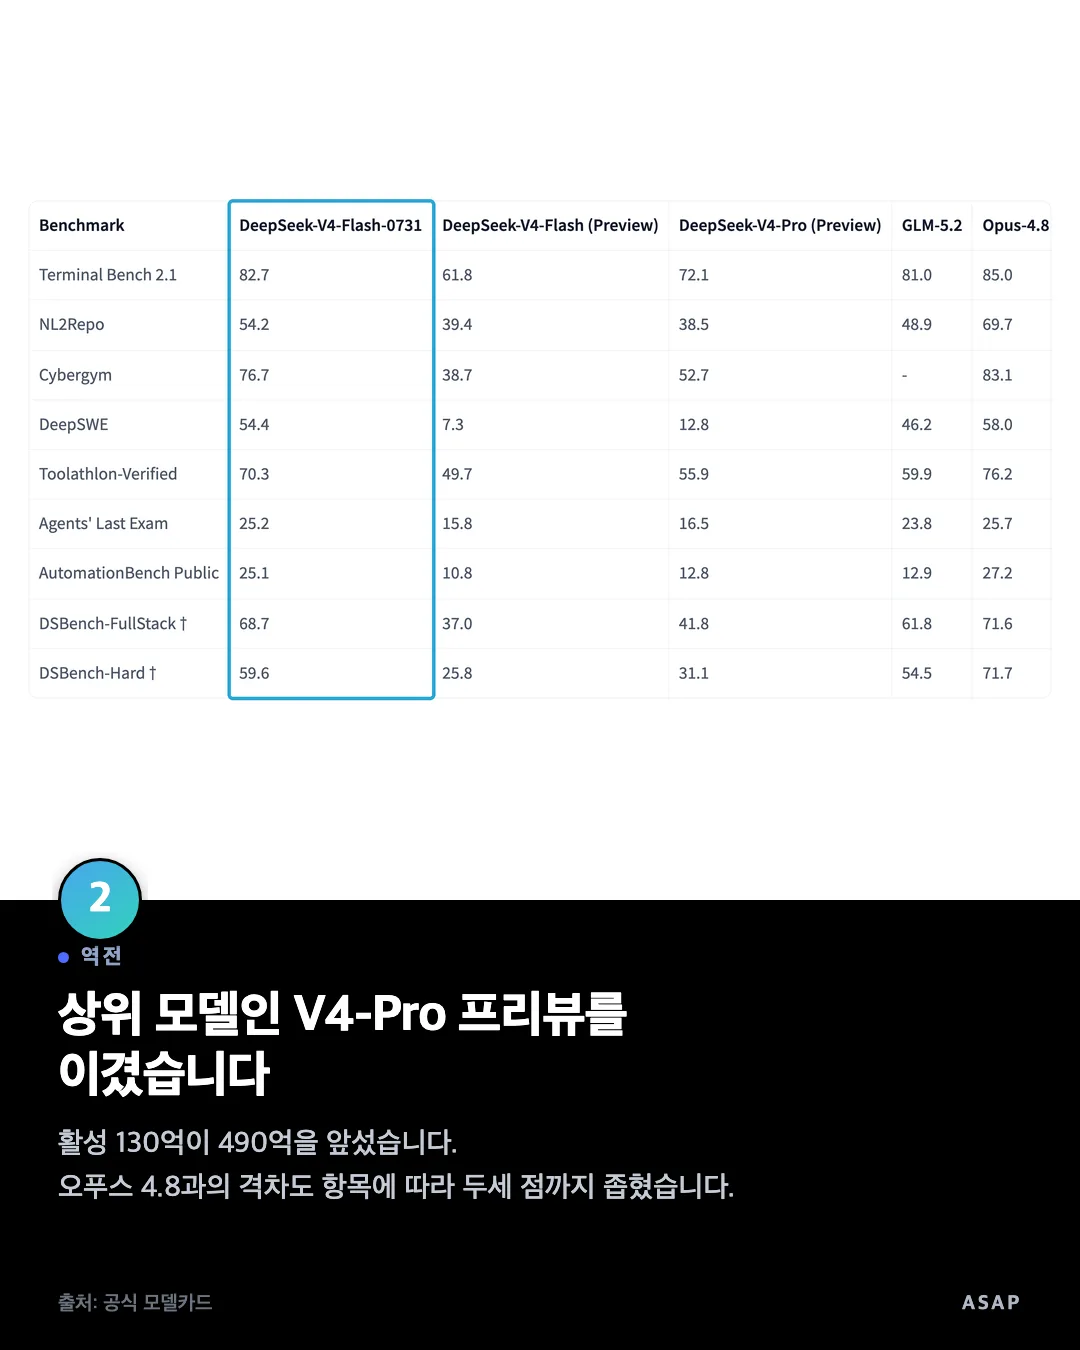
숫자가 셉니다. 코딩 에이전트 벤치마크인 DeepSWE에서 7.3점이던 것이 54.4점이 됐습니다. 사이버짐은 38.7에서 76.7로, 터미널벤치 2.1은 61.8에서 82.7로 올랐습니다. 모델 크기는 그대로입니다. 후속 학습만 바꿔 만든 폭입니다.
더 눈에 띄는 건 체급 역전입니다. 이 모델은 전체 2,840억 개 중 130억 개만 켜서 씁니다. 같은 회사 상위 모델인 V4-Pro 프리뷰는 490억 개를 켭니다. 그런데 공개된 아홉 개 벤치마크 전부에서 Flash 정식판이 앞섭니다. 터미널벤치는 82.7 대 72.1이고 DeepSWE는 54.4 대 12.8입니다.
비공개 모델과의 거리도 좁혔습니다. 앤트로픽 오푸스 4.8과 비교하면 터미널벤치가 82.7 대 85.0이고 에이전트 라스트 이그잼은 25.2 대 25.7입니다. 항목에 따라 두세 점 차이까지 붙었습니다.
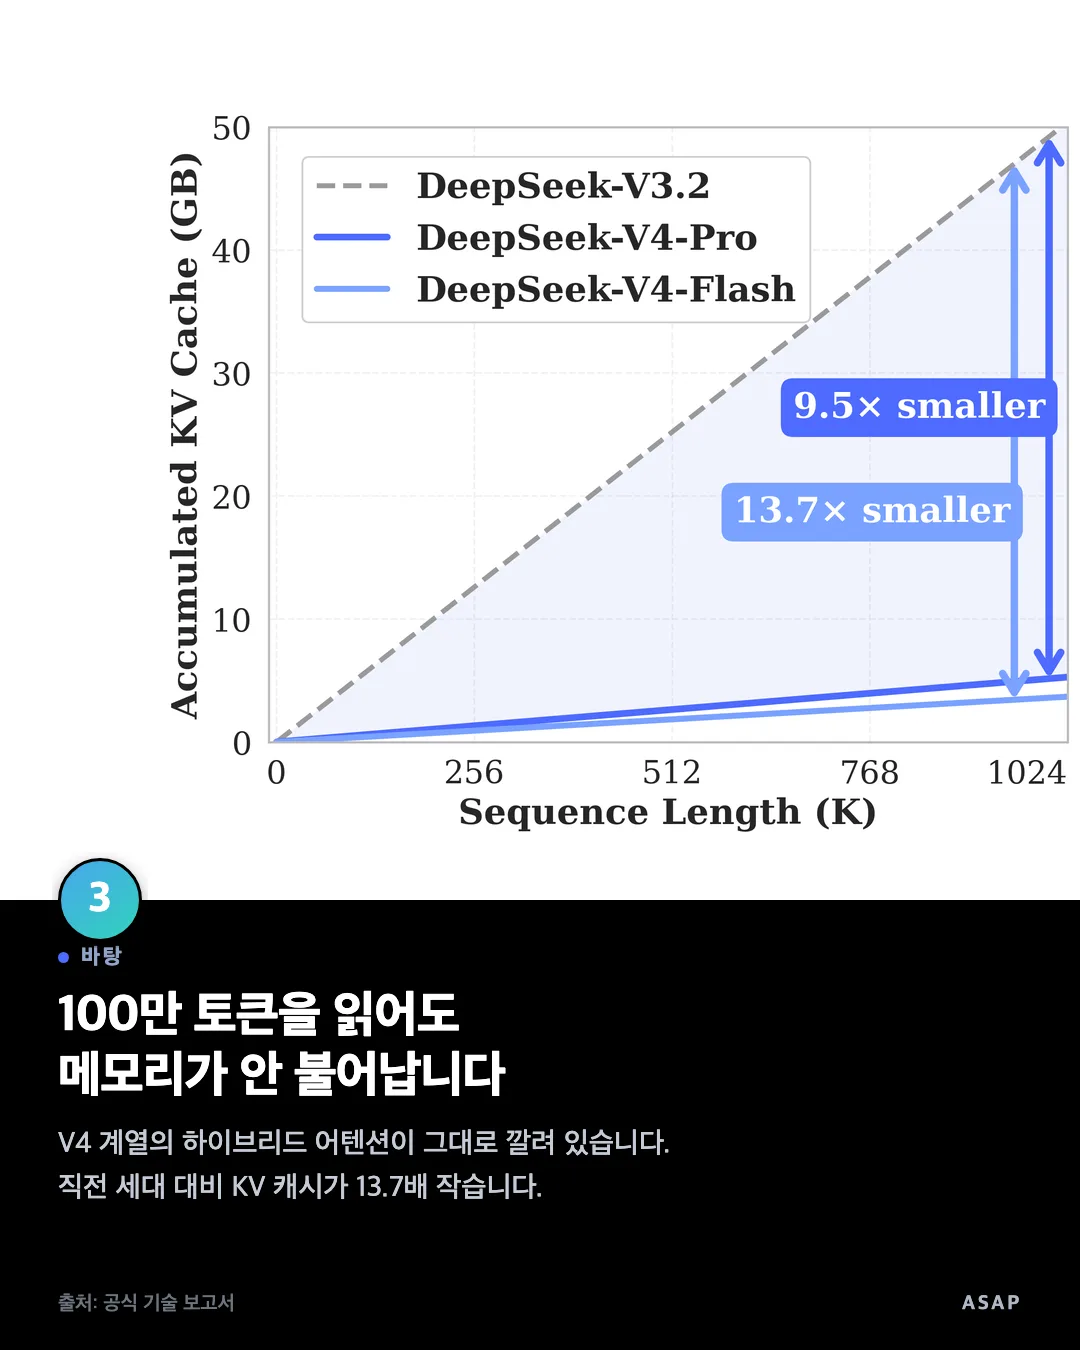
바탕에는 V4 계열의 구조가 그대로 깔려 있습니다. 압축 희소 어텐션과 고압축 어텐션을 섞어 100만 토큰을 다루면서도 KV 캐시를 직전 세대의 13.7분의 1로 줄인 설계입니다. 긴 문서를 읽힐수록 메모리가 불어나 비용이 오르던 문제를 건드린 부분입니다.
실무에서 쓸 때 달라진 것도 있습니다. 투기적 디코딩 모듈이 모델에 함께 붙어 나옵니다. vLLM이나 SGLang에서 플래그 하나로 켭니다. 추론 강도는 저·고·최대 세 단계로 조절합니다. 챗 템플릿 대신 인코딩 스크립트를 따로 제공합니다.
짚어둘 것도 있습니다. 벤치마크는 딥시크가 자체 측정해 공개한 것입니다. 코드 에이전트 항목은 아직 공개되지 않은 자체 프레임워크로 잰 수치이고, DSBench 두 항목은 내부 테스트셋입니다. 비교 조건이 완전히 같다고 보기는 어렵습니다.
그래도 방향은 분명합니다. 파라미터를 키우는 대신 같은 크기에서 후속 학습으로 끌어올렸습니다. 라이선스는 MIT입니다.
출처 DeepSeek-V4-Flash-0731 공식 모델카드(2026.07.31) · 기술 보고서(arXiv 2606.19348)