합성 이미지로 안전 감지 모델을 학습시킨 AWS
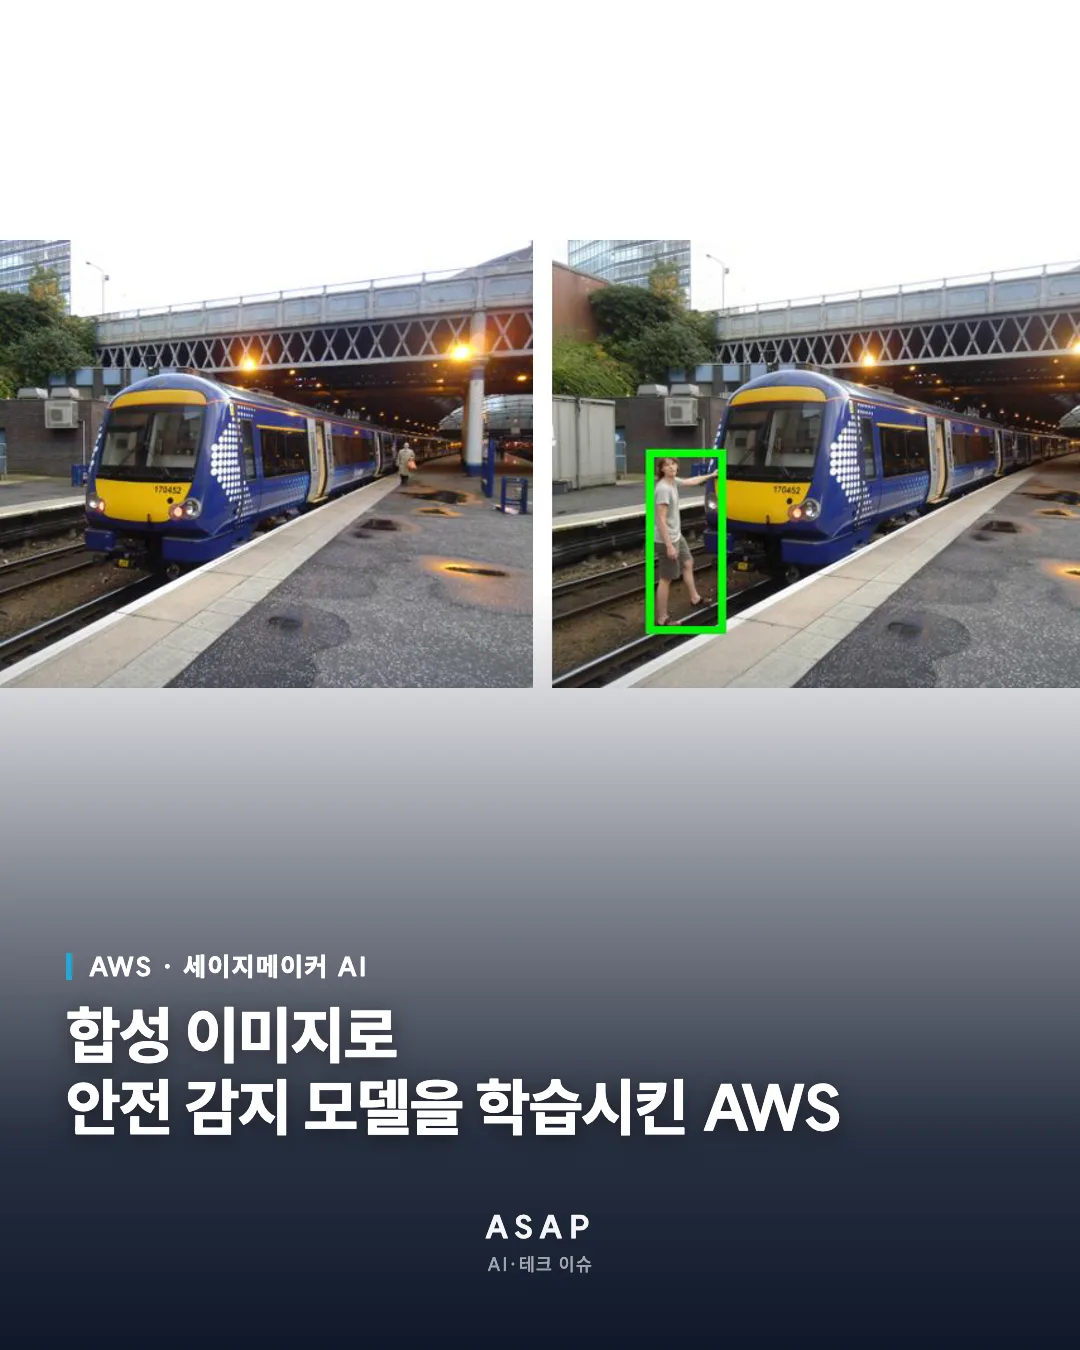
사람이 열차 앞에 서 있는 사진은 구할 수가 없습니다. 위험하니까요. AWS가 실제 현장 사진에 사람만 합성해 안전 감지 모델을 학습시킨 실험을 공식 블로그에 공개했습니다.
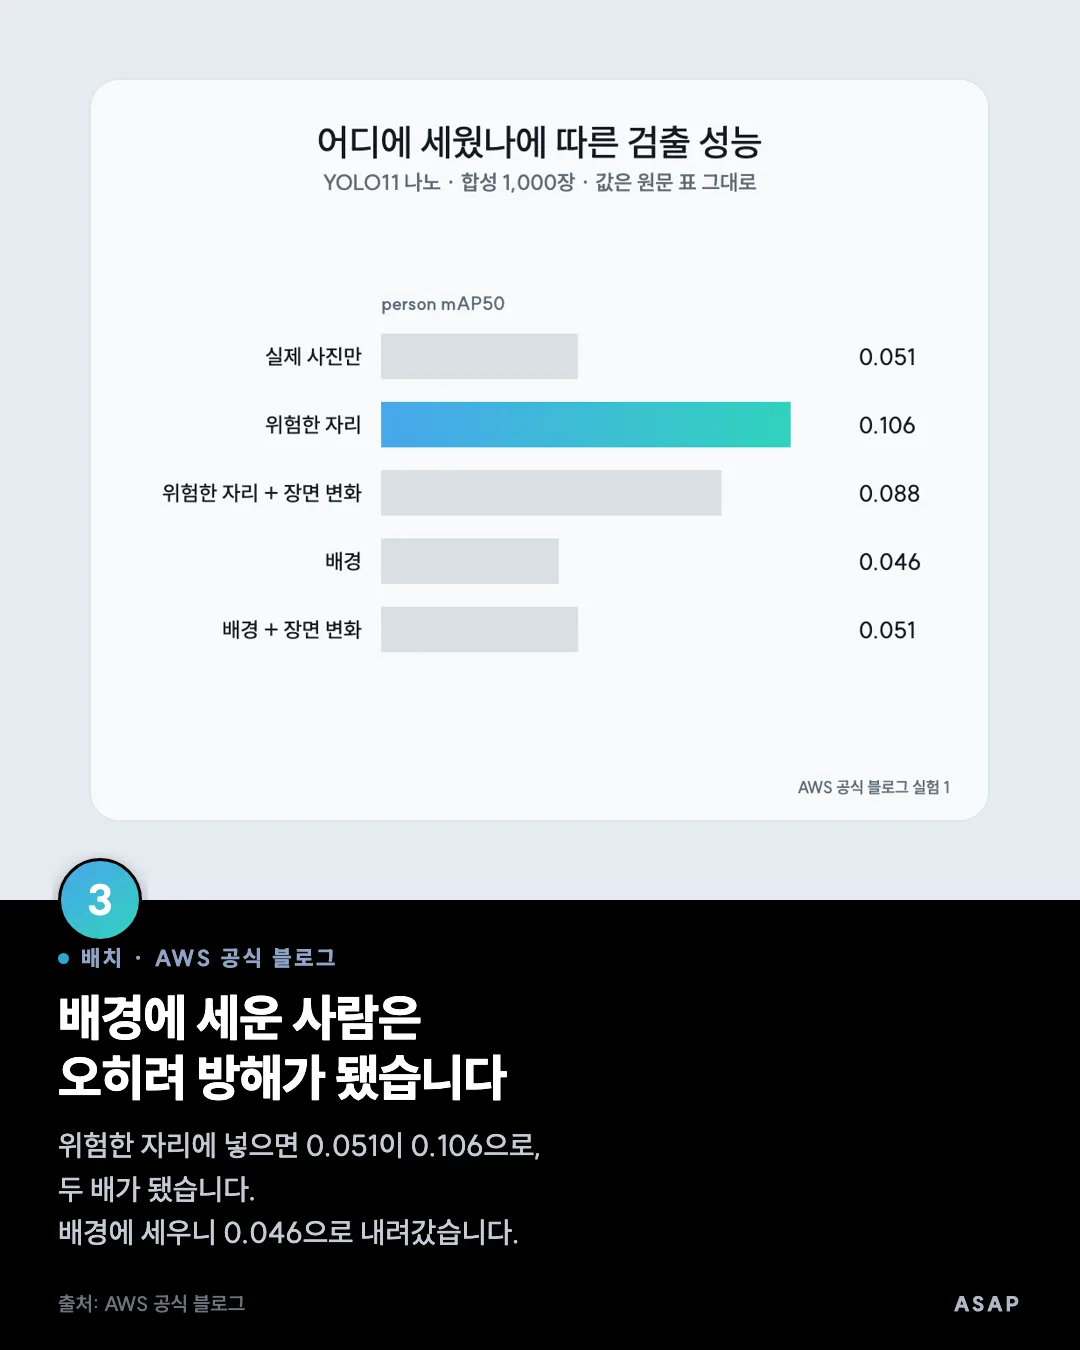
핵심은 양이 아니라 배치였습니다. 사람을 위험한 자리에 넣으면 검출 성능이 0.051에서 0.106으로 두 배가 됐는데, 배경에 세우면 0.046으로 오히려 떨어졌습니다.
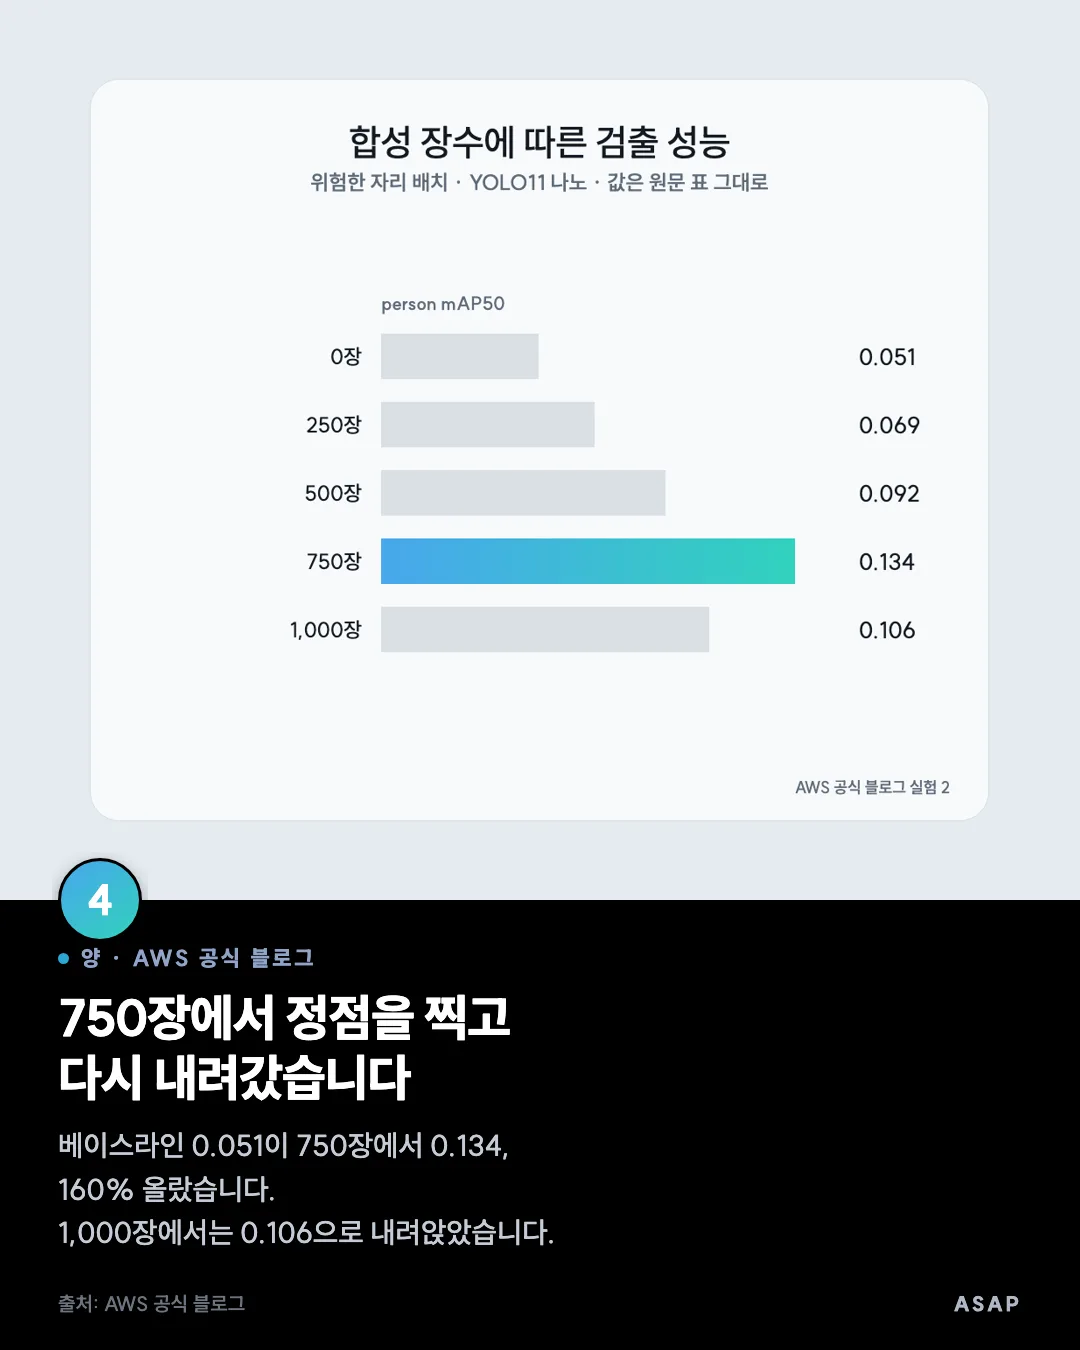
많이 넣을수록 좋아지지도 않았습니다. 750장에서 0.134로 정점을 찍고 1,000장에서는 0.106으로 내려앉았습니다. 생성 결함이 쌓여 잡음이 된 탓입니다.
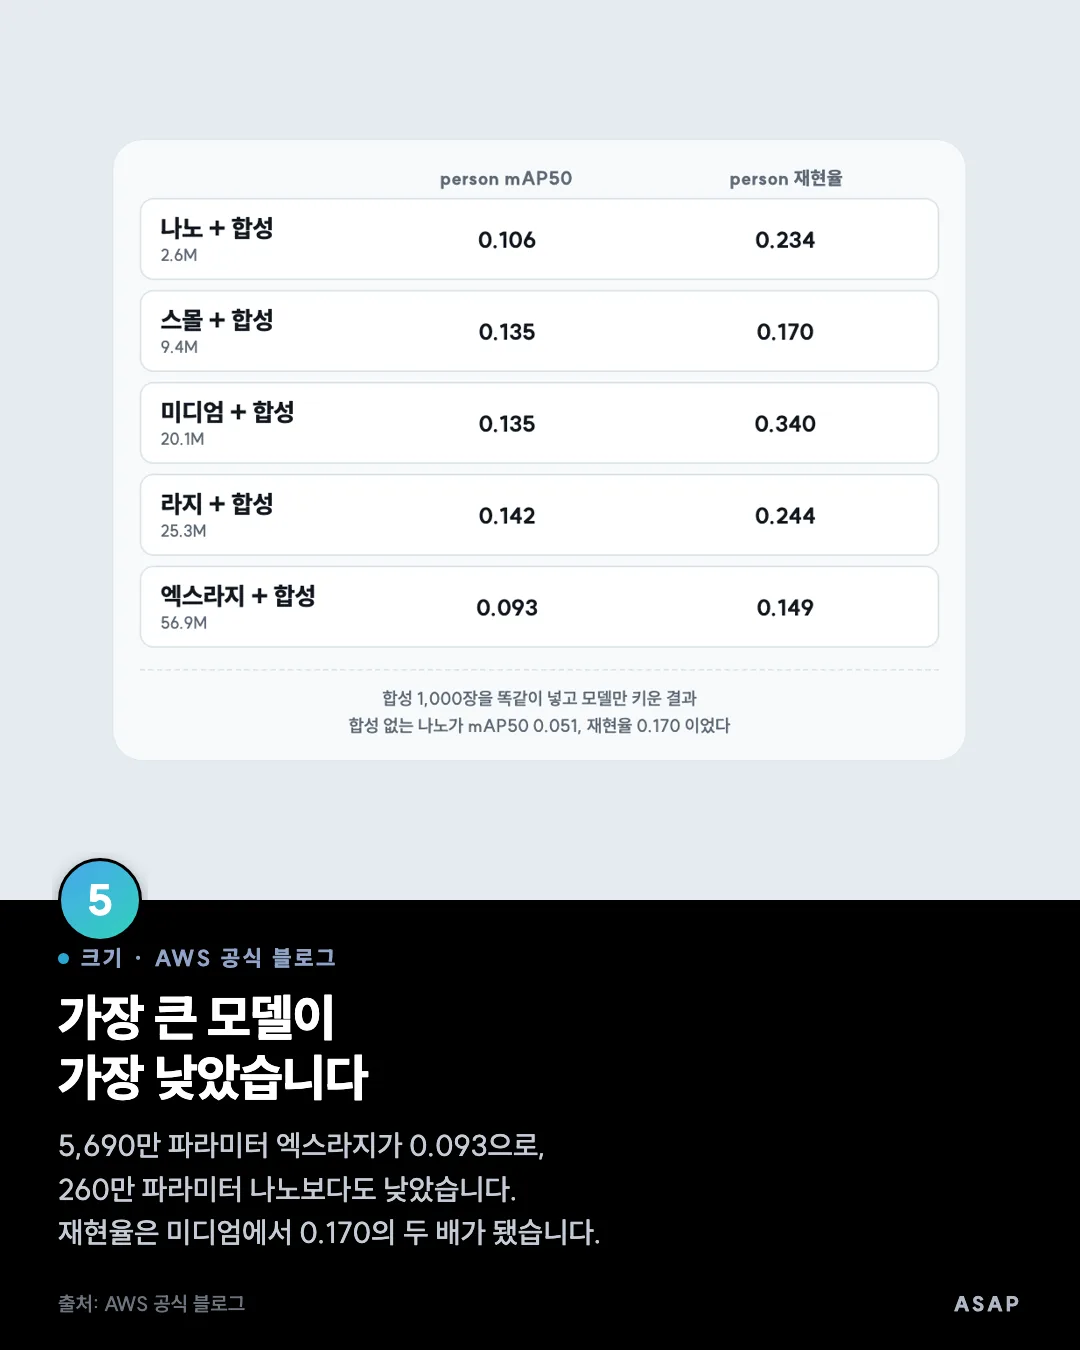
모델도 마찬가지입니다. 5,690만 파라미터짜리가 260만 파라미터에 합성을 더한 쪽보다 낮았습니다. 학습 이미지가 4,200장뿐이라 큰 모델을 붙잡아 줄 데이터가 모자랐습니다.
가장 중요한 숫자는 재현율입니다. 위험한 자리에 있는 사람을 놓치지 않는 비율이 17%에서 34%로 올랐습니다.
출처 AWS 공식 블로그(2026-09-17)
카드 내용
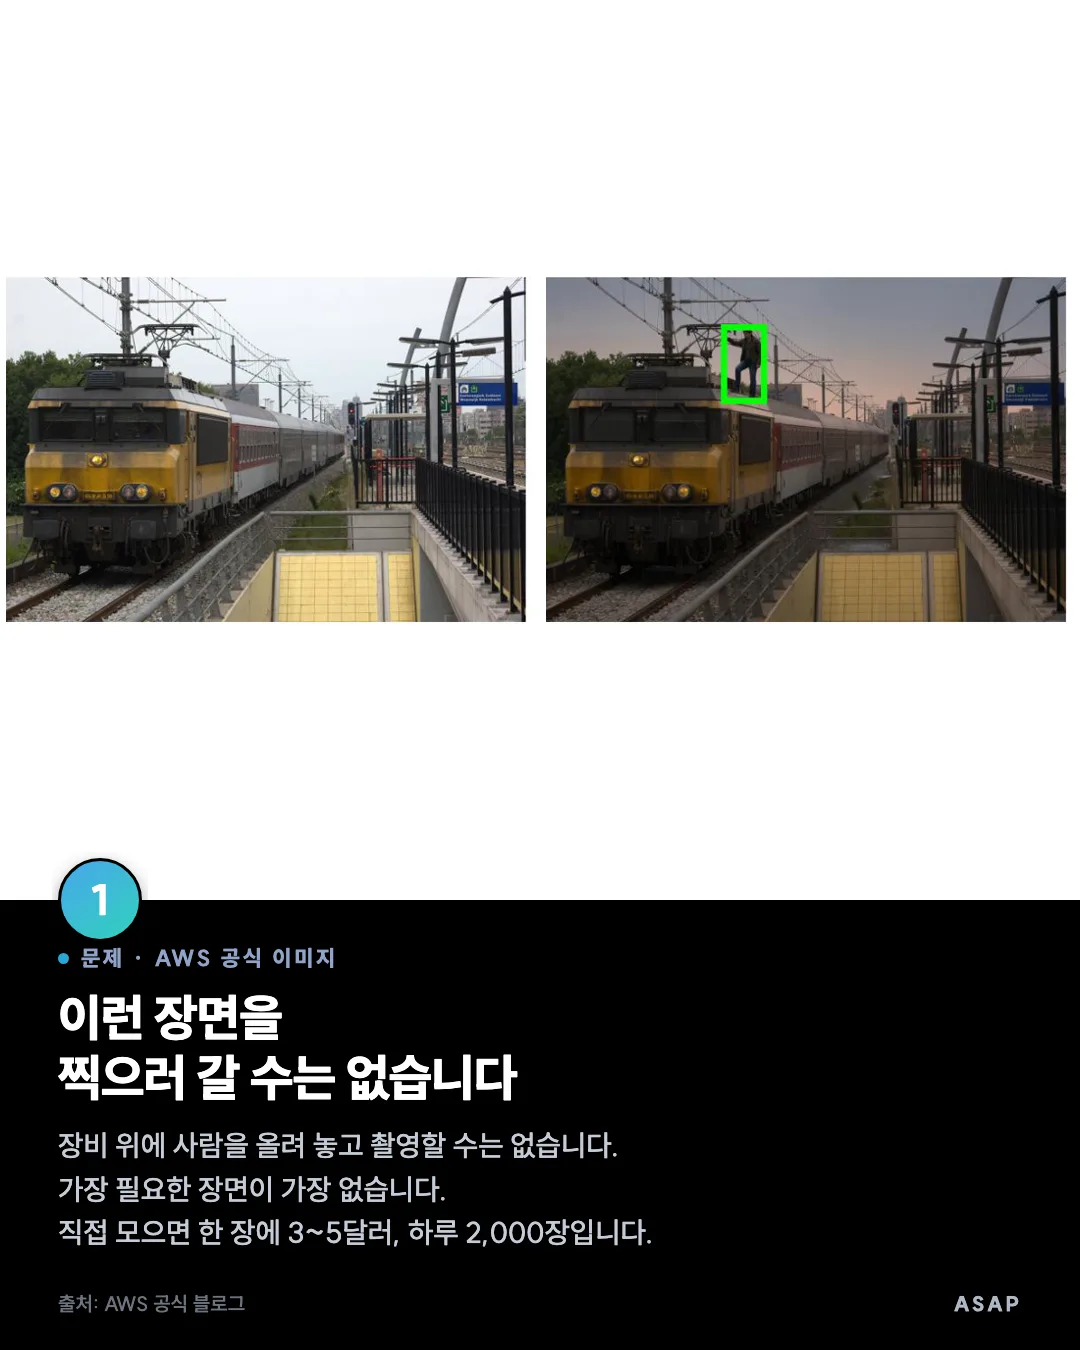
- 문제 · AWS 공식 이미지이런 장면을 찍으러 갈 수는 없습니다
장비 위에 사람을 올려 놓고 촬영할 수는 없습니다. 가장 필요한 장면이 가장 없습니다. 직접 모으면 한 장에 3~5달러, 하루 2,000장입니다.
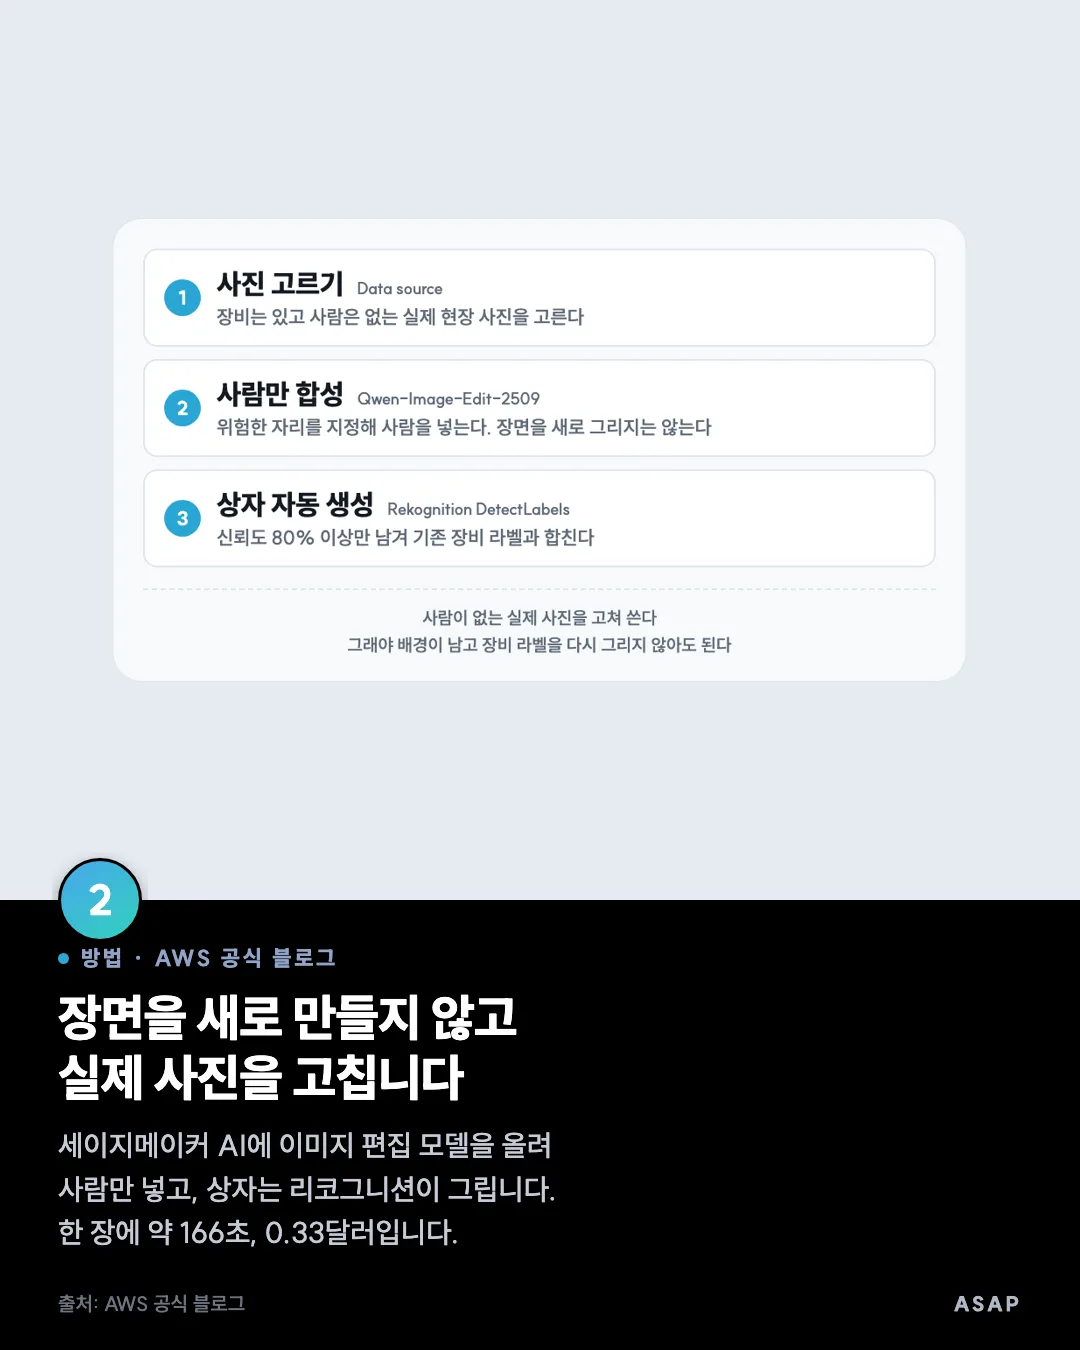
출처: AWS 공식 블로그 - 방법 · AWS 공식 블로그장면을 새로 만들지 않고 실제 사진을 고칩니다
세이지메이커 AI에 이미지 편집 모델을 올려 사람만 넣고, 상자는 리코그니션이 그립니다. 한 장에 약 166초, 0.33달러입니다.
출처: AWS 공식 블로그 - 배치 · AWS 공식 블로그배경에 세운 사람은 오히려 방해가 됐습니다
위험한 자리에 넣으면 0.051이 0.106으로, 두 배가 됐습니다. 배경에 세우니 0.046으로 내려갔습니다.
출처: AWS 공식 블로그 - 양 · AWS 공식 블로그750장에서 정점을 찍고 다시 내려갔습니다
베이스라인 0.051이 750장에서 0.134, 160% 올랐습니다. 1,000장에서는 0.106으로 내려앉았습니다.
출처: AWS 공식 블로그 - 크기 · AWS 공식 블로그가장 큰 모델이 가장 낮았습니다
5,690만 파라미터 엑스라지가 0.093으로, 260만 파라미터 나노보다도 낮았습니다. 재현율은 미디엄에서 0.170의 두 배가 됐습니다.
출처: AWS 공식 블로그