구글 딥마인드가 낸 Dream-RSI 기술 리포트
에이전트가 자기 탐색 전략을 고치는데, 그걸 고치는 동안 아무것도 실행하지 않습니다.
구글과 메릴랜드대, 구글 딥마인드가 낸 Dream-RSI 기술 리포트입니다. 자기개선의 병목으로 탐색 정책을 지목합니다. 어디서 가지를 칠지, 무엇을 병렬로 돌릴지, 언제 끊을지를 정하는 그 부분만 아직 사람이 써 놓고 고정해 둔다는 겁니다. 고치려면 정책 하나당 발견 과정을 끝까지 돌려 봐야 해서 비용이 감당이 안 됩니다.
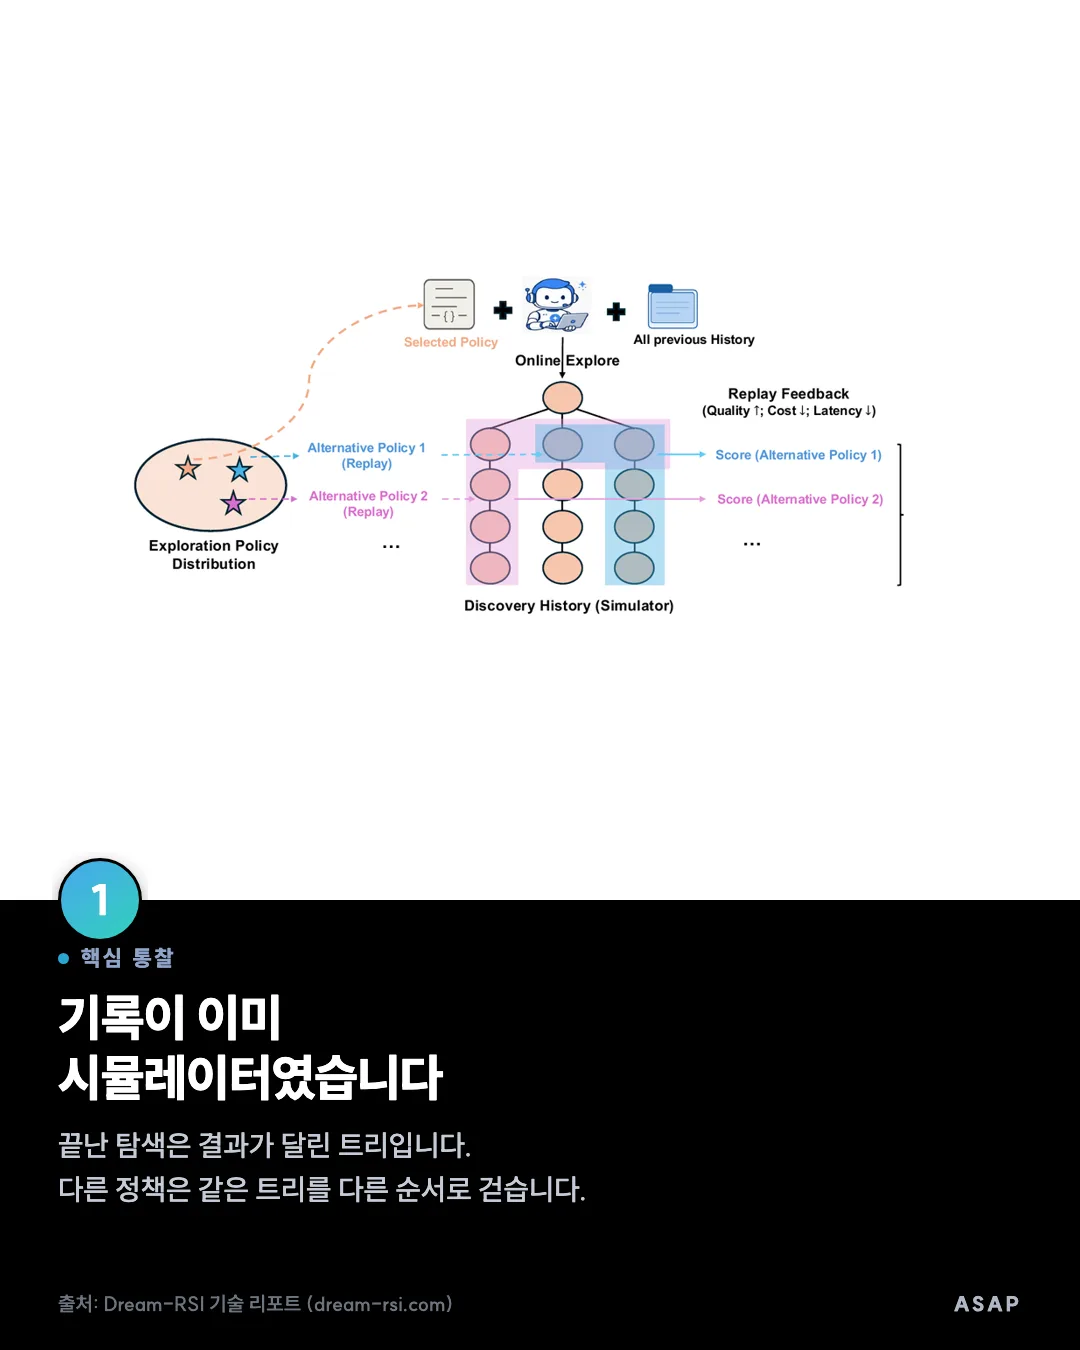
여기서 이들이 본 게 있습니다. 이미 끝난 탐색 기록이 그 자체로 시뮬레이터라는 것입니다. 끝난 탐색은 읽을 텍스트가 아니라 결정마다 실행 결과가 붙어 있는 트리입니다. 다른 정책은 같은 트리를 다른 순서로 걸을 뿐이고 필요한 결과는 전부 디스크에 있습니다. 학습한 세계 모델과 달리 근사가 아니라 정확합니다. 실제로 지나간 공간 그 자체이기 때문입니다.
- 후보 정책 수천 개를 실행 0회로 채점하고 이긴 하나만 실제로 배포합니다
- 지금 쓰는 정책도 후보에 넣기 때문에 새 정책이 이전보다 나빠질 수 없습니다
- 한 바퀴 돌 때마다 새 트리가 쌓여 시뮬레이터가 늘어납니다. 그게 재귀가 되는 지점입니다
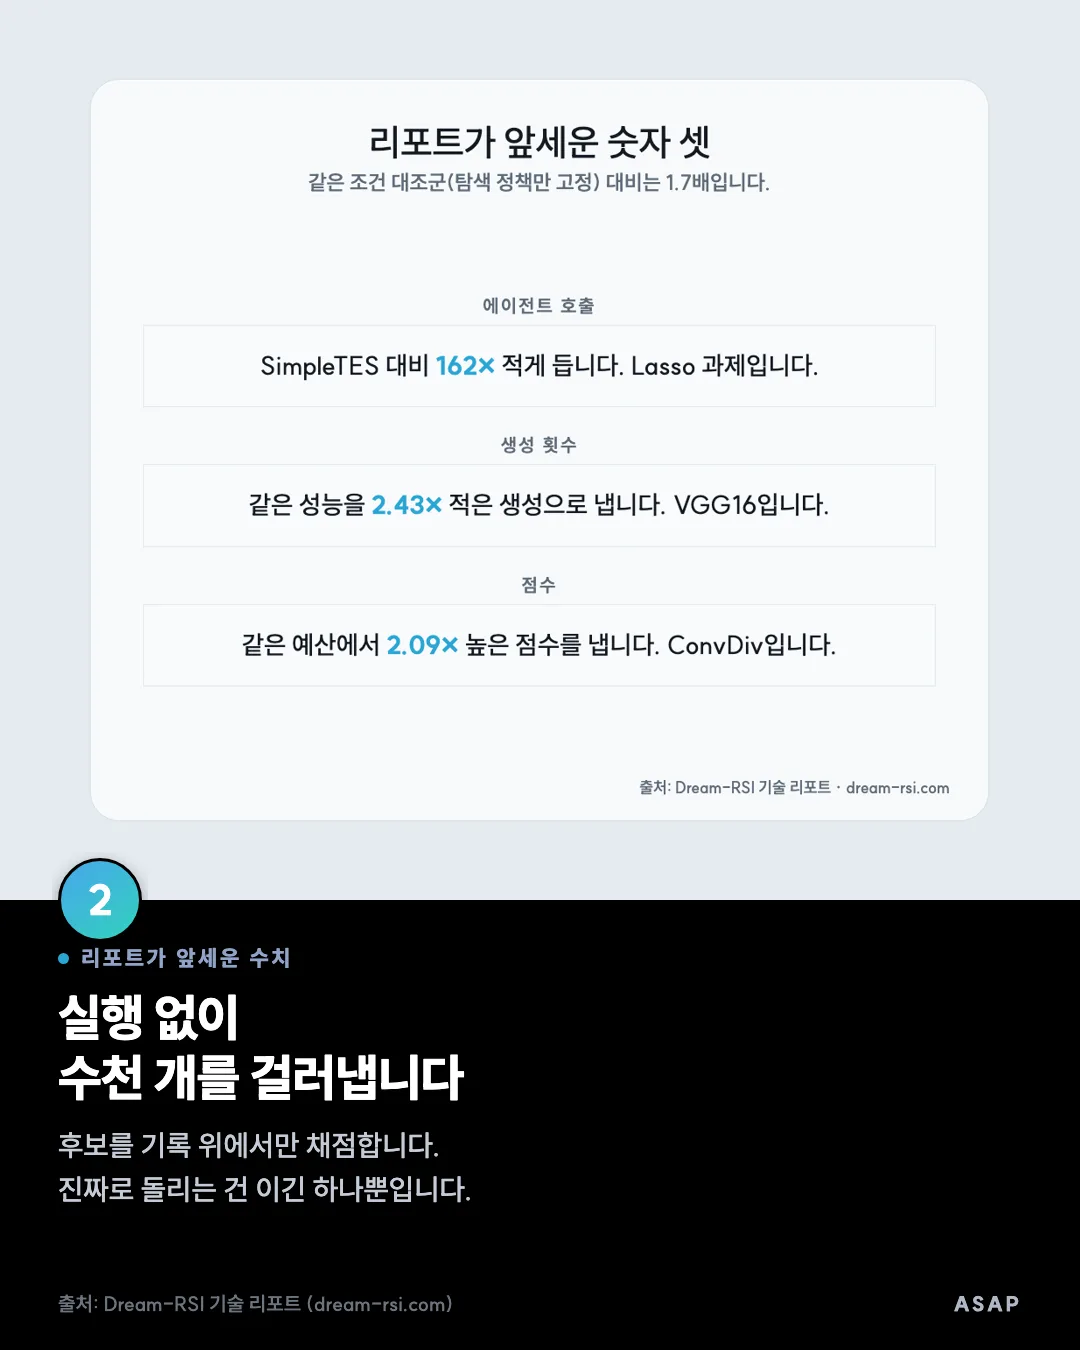
- VGG16에서 같은 성능을 2.43배 적은 생성으로, ConvDiv에서 같은 예산에 2.09배 높은 점수를 냅니다
- Lasso에서는 SimpleTES보다 에이전트 호출이 162배 적습니다
- 다만 같은 조건 대조군인 고정 탐색과 비교하면 1.7배입니다. 162배는 다른 방식과의 비교입니다
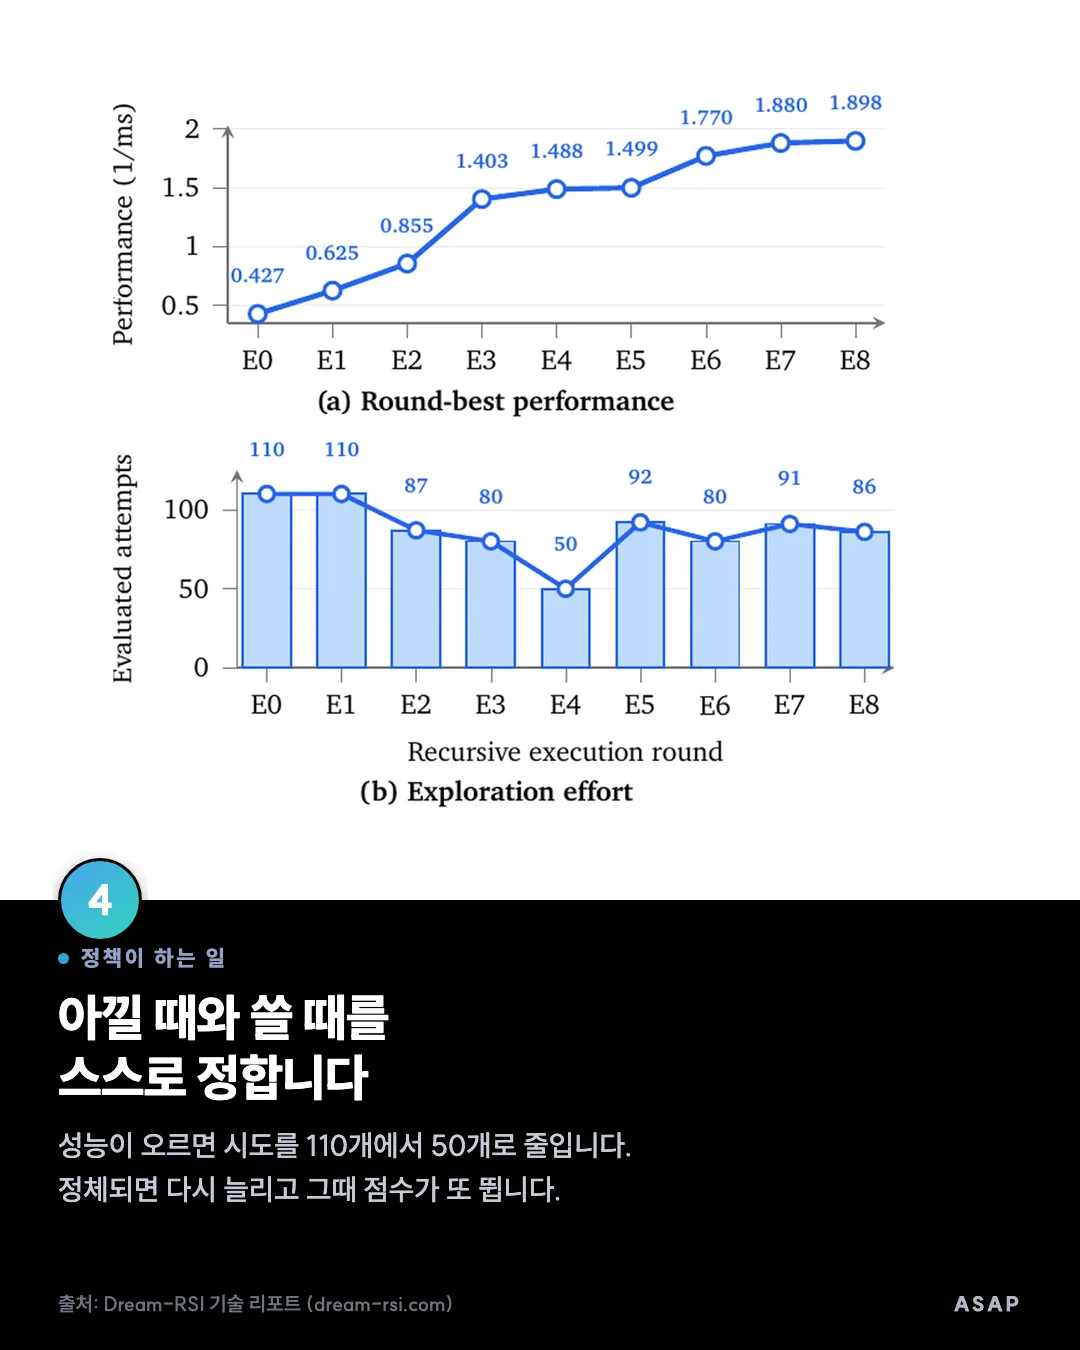
- 학습된 정책은 무작정 넓히지 않습니다. 성능이 오르면 시도를 110개에서 50개로 줄입니다
- 과거 궤적을 요약해 프롬프트에 넣는 방식은 같은 예산에서 오히려 더 나빴다고 밝혔습니다
- 고치는 것은 탐색 정책 코드이고 밑에서 도는 코딩 에이전트는 그대로 둡니다
출처 Dream-RSI 기술 리포트 (dream-rsi.com, 2026)
광고
카드 내용
- 핵심 통찰기록이 이미 시뮬레이터였습니다
끝난 탐색은 결과가 달린 트리입니다. 다른 정책은 같은 트리를 다른 순서로 걷습니다.
출처: Dream-RSI 기술 리포트 (dream-rsi.com) - 리포트가 앞세운 수치실행 없이 수천 개를 걸러냅니다
후보를 기록 위에서만 채점합니다. 진짜로 돌리는 건 이긴 하나뿐입니다.
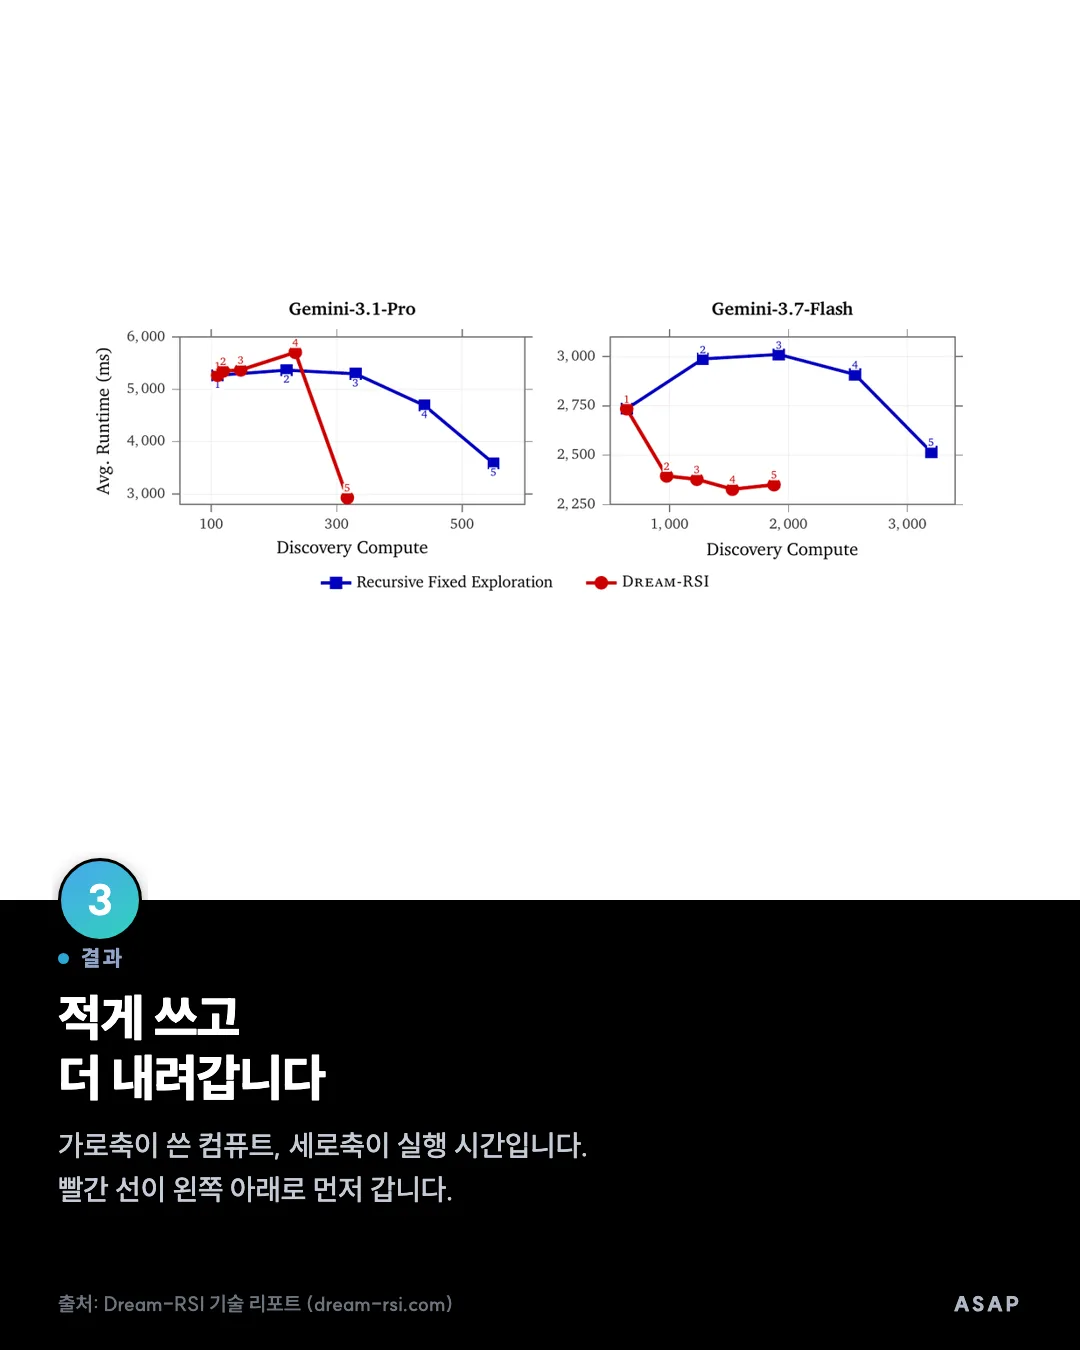
출처: Dream-RSI 기술 리포트 (dream-rsi.com) - 결과적게 쓰고 더 내려갑니다
가로축이 쓴 컴퓨트, 세로축이 실행 시간입니다. 빨간 선이 왼쪽 아래로 먼저 갑니다.
출처: Dream-RSI 기술 리포트 (dream-rsi.com) - 정책이 하는 일아낄 때와 쓸 때를 스스로 정합니다
성능이 오르면 시도를 110개에서 50개로 줄입니다. 정체되면 다시 늘리고 그때 점수가 또 뜁니다.
출처: Dream-RSI 기술 리포트 (dream-rsi.com)
광고